最佳实践:引擎执行记录分析
OpenInsight 可以让 Agent 从计算引擎审计日志拉出当天耗时 TOP N 的 SQL,先按来源判断主矛盾,再按问题特征归类,最后把单条慢 SQL 下钻到 SQL 性能优化 做执行计划级诊断。
适用场景:集群变慢、ETL 堆积、要快速回答「今天慢 SQL 主要在哪、先改谁」。
对话:今天耗时 TOP100 并归类
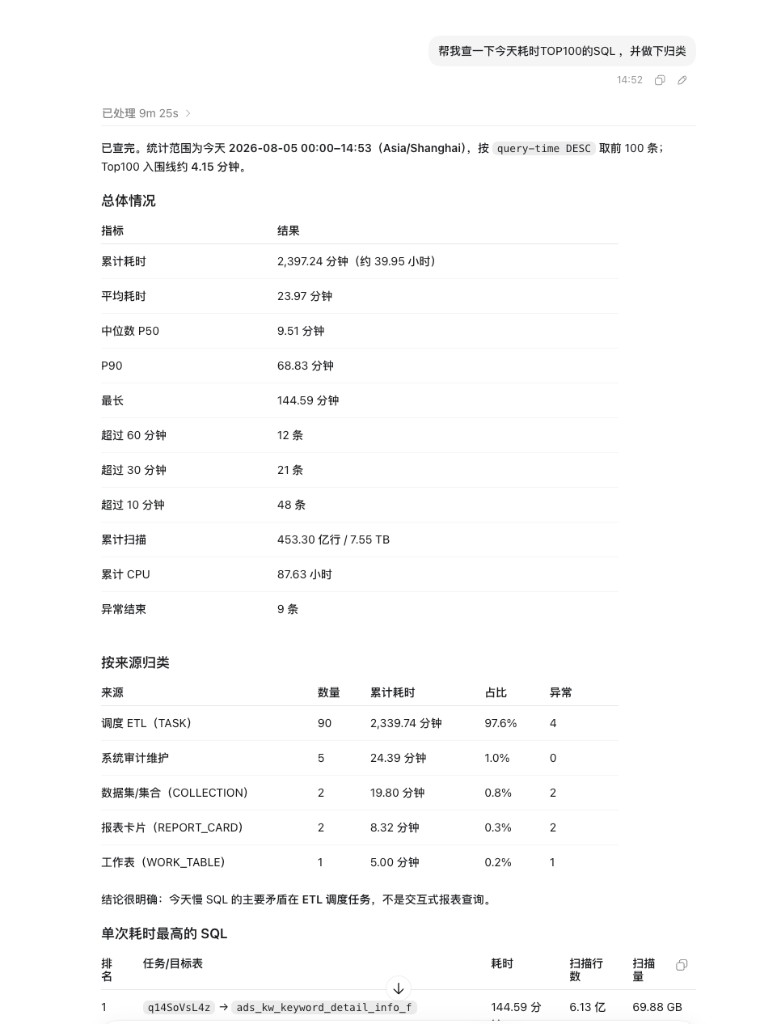
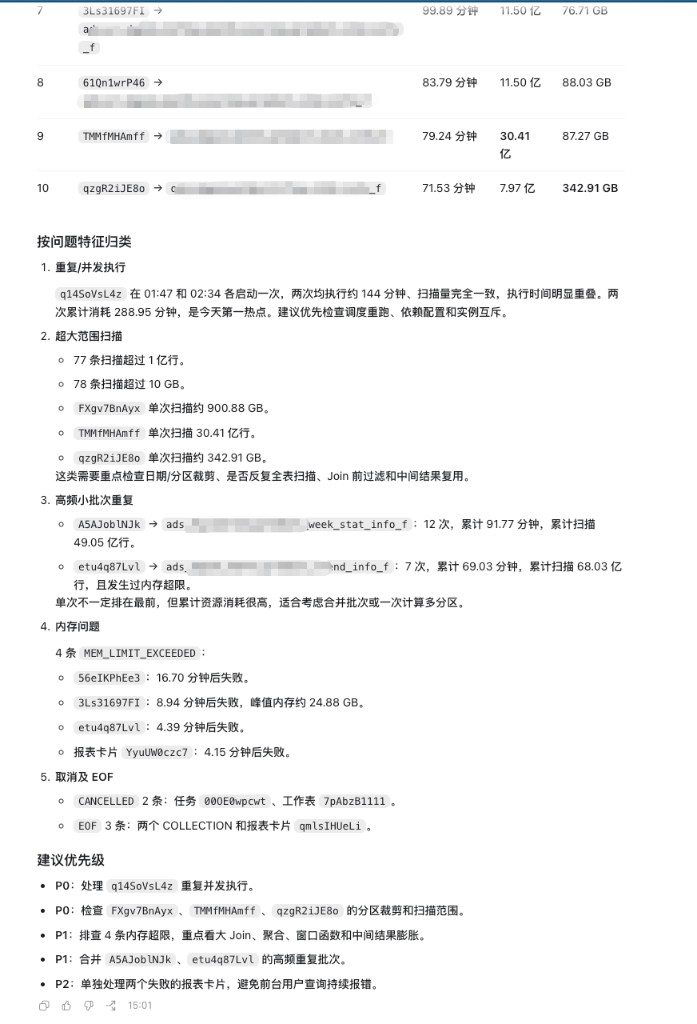
问题: 帮我查一下今天耗时 TOP100 的 SQL,并做下归类。
案例分析:
- 拉清单:用
cluster history按query-time DESC取当天 TOP100,确认入榜门槛与时间窗口。 - 总体画像:汇总累计/平均/分位耗时、扫描量、CPU、异常结束数,先回答「今天有多慢」。
- 按来源归类:区分调度 ETL(TASK)、系统审计、数据集(COLLECTION)、报表卡片(REPORT_CARD)、工作表(WORK_TABLE)等,判断主矛盾在离线还是交互。报表卡片打开慢时,先走 排查卡片打开耗时过久,不要把打开耗时直接当成引擎 SQL 耗时。
- 按问题特征归类:重复/并发执行、超大范围扫描、高频小批次重复、内存超限、取消/EOF。
- 给优先级:P0 先止血(并发重跑、超大扫描),P1 治本(内存/批合并),P2 处理对用户可见的报表失败。
- 单条下钻:对 TOP 条目给出可点击的任务/目标表,继续走
taskrun diagnose与 SQL 改写。
# 取当天按耗时排序的 TOP100(limit 最大 200)
openinsight cluster history \
  --start-time '2026-08-05 00:00' \
  --end-time '2026-08-05 14:53' \
  --order-by query-time:desc \
  --limit 100 \
  --format records

# 也可按扫描行数 / CPU / 内存排热点
openinsight cluster history \
  --start-time '2026-08-05 00:00' \
  --end-time '2026-08-05 23:59' \
  --order-by scan-rows:desc \
  --limit 50
联动:单条 SQL 性能分析
清单分析回答「先改谁」;单条诊断回答「怎么改」。对 TOP 中的 TASK,继续:
# 从任务编码 / 实例链接定位
openinsight location 'https://example.com/#/task/instance/<instance-id>'
openinsight task instances --task-code <task-code> --start-time '2026-08-05 00:00'

# 拆日志 + 执行计划异常算子
openinsight taskrun log --taskrun-id <taskrun-id> --line 300
openinsight taskrun diagnose <taskrun-id> --format table
完整改写路径(异常算子 → SQL 改写 → Join 方案)见 SQL 性能优化。
推荐闭环:
cluster history --order-by query-time:desc找 TOP N 与归类。- 对 P0/P1 的 TASK,用
taskrun diagnose落到算子级证据。 - 按 SQL 性能优化 给出可执行改写,再回看次日 TOP 是否退出榜单。
适用场景
- 值班巡检:今天慢 SQL 主要在哪一类来源。
- 容量与成本:扫描量 / CPU 热点是否集中在少数任务。
- 调度稳定性:是否存在并发重跑、高频小批次。
- 与单 SQL 优化衔接:从集群热点下钻到具体任务实例与执行计划。