最佳实践:排查卡片打开耗时过久
OpenInsight 可以让 Agent 先按时间段拉出「哪些卡片打开较久」,再对单张卡片拆开总耗时、服务端链路和引擎 SQL,判断慢在配置膨胀、SQL 生成、计算引擎,还是结果传输 / 前端渲染。
适用场景:看板打开卡顿、某张卡片偶发或持续慢、需要回答「今天慢的是哪几张、先看谁」。
不要把卡片打开慢直接当成引擎 SQL 慢。打开耗时包含 SQL 生成、引擎执行、缓存、序列化传输和前端组装;引擎 SQL 往往只占其中一段。
步骤 1:查询某时间段的卡片查询记录
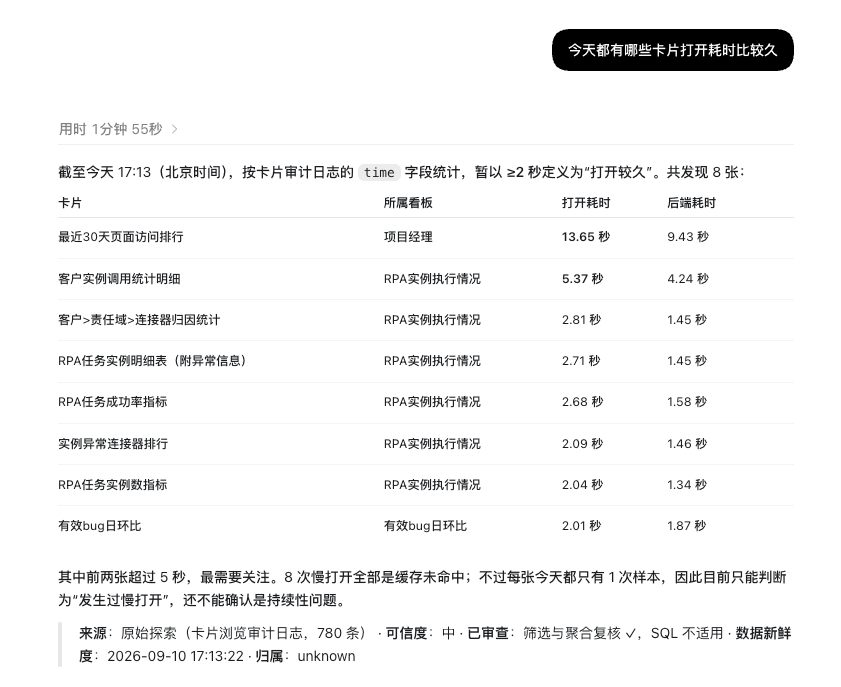
问题: 今天都有哪些卡片打开耗时比较久。
Agent 思路:
- 用
audit-log list --resource-type chart --operation-type view --all拉该时间段的卡片浏览日志(事件为「仪表盘卡片-加载时间」)。 - 表格里的
time是日志发生时间,不是打开耗时。打开耗时在每条记录后面的operationDetailsJSON 里,字段通常是time,单位为毫秒。 - 同时读取
objectId(cardId)、operationSummary(卡片名)、description(所属看板)以及 JSON 中的服务端 / 后端耗时、缓存状态(若有)。 - 给出工作定义,例如暂以 ≥ 2 秒 为「打开较久」,按卡片聚合后输出打开耗时、后端耗时、所属看板。
- 标明样本:当天只有 1 次慢打开,只能判断为「发生过慢打开」,还不能确认是持续性问题。
# 默认:今天 00:00:00 到当前时刻;必须加 --all,否则只拉一页点击日志
openinsight audit-log list \
  --resource-type chart \
  --operation-type view \
  --all

# 指定时间窗
openinsight audit-log list \
  --from '2026-09-10T00:00:00' \
  --to '2026-09-10T17:13:00' \
  --resource-type chart \
  --operation-type view \
  --all
要点:
- 该组合走预策点击日志,不是普通业务审计日志;远端可能有数万条点击事件,客户端只保留「仪表盘卡片-加载时间」且含
cardId的记录。 - 不加
--all时默认第 1 页 100 条,过滤后往往样本不足,排行不可信。 --object-id在此场景按cardId本地过滤,并会自动拉全部分页。
operationDetails 里常见字段:
| 字段 | 含义 |
|---|---|
cardId | 卡片远端 ID,对应输出的 objectId |
cardName | 卡片名称 |
reportName | 所属看板 |
status | 如 SUCCESS / LOADING |
time | 打开总耗时,通常为毫秒 |
| 其它阶段字段 | 若 JSON 中带服务端耗时、缓存命中等,一并用于「后端耗时」列;没有就不要编造 |
步骤 2:查询某卡片具体慢的原因
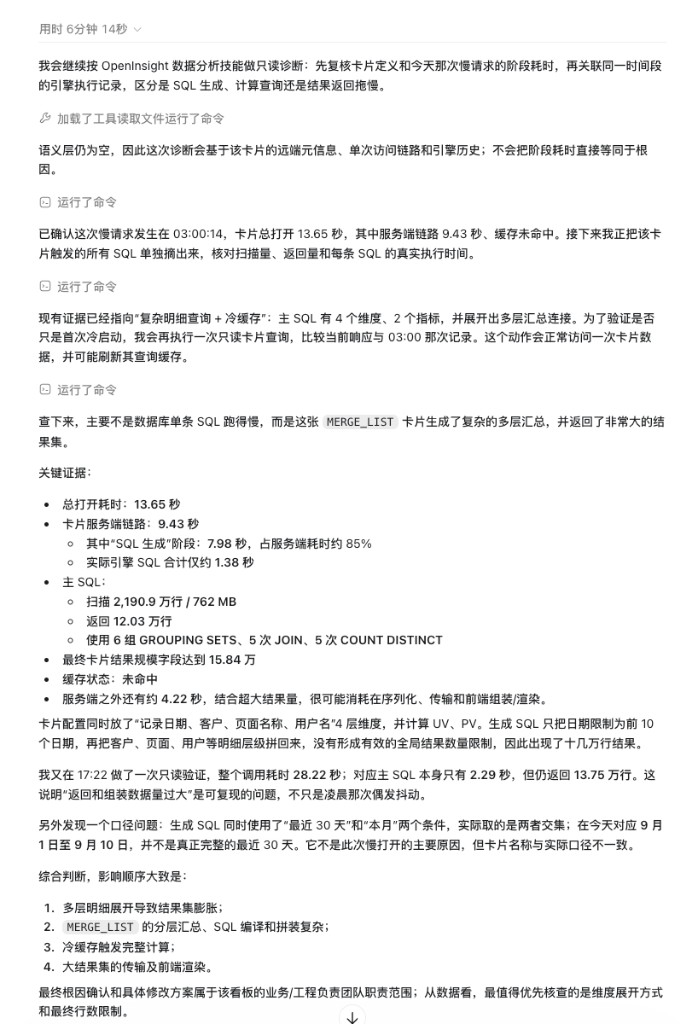
问题: 这张最慢的卡片为什么打开要十几秒。
Agent 思路:
- 先钉住那一次慢打开:用
--object-id <cardId>拉该卡片当天记录,确认发生时间、总打开耗时、服务端耗时、缓存是否命中。 - 读卡片定义:
chart get看卡片类型、维度、指标、过滤条件和生成 SQL,判断是否多层明细展开、MERGE_LIST分层汇总、无结果行数限制。 - 对齐同一时间窗的引擎历史:用
cluster history把该卡片触发的 SQL 单独摘出,核对扫描量、返回行数、queryTime。不要把服务端耗时直接当成引擎执行时间。 - 拆阶段,而不是直接下根因:总打开耗时 = SQL 生成 + 引擎 SQL + 缓存未命中带来的完整计算 + 结果序列化 / 传输 / 前端渲染。
- 只读复现要谨慎:
chart query会真实访问一次卡片数据,并可能刷新查询缓存;适合验证「是不是结果集过大」,不适合在生产高峰反复打。 - 结论落到可检查项:例如维度展开导致结果膨胀、冷缓存触发完整计算、大结果集传输。最终改配置 / 改 SQL 属于看板业务或工程团队职责;Agent 只提供数据证据。
# 该卡片在时间窗内的全部打开记录(传入 --object-id 会自动拉全部分页)
openinsight audit-log list \
  --from '2026-09-10T00:00:00' \
  --to '2026-09-10T17:13:00' \
  --resource-type chart \
  --operation-type view \
  --object-id <cardId>

# 卡片定义:类型、维度、指标、过滤、SQL
openinsight chart get <cardId> --dashboard <dashboard_id>

# 慢打开前后几分钟的引擎 SQL(按耗时排序)
openinsight cluster history \
  --start-time '2026-09-10 03:00' \
  --end-time '2026-09-10 03:05' \
  --order-by query-time:desc \
  --limit 50 \
  --format records

# 可选:只读复现一次(可能刷新缓存)
openinsight chart query <cardId> --dashboard <dashboard_id> --format json
阶段对照(用证据填写,缺字段就写未知):
| 阶段 | 怎么看 | 常见信号 |
|---|---|---|
| 打开总耗时 | 点击日志 operationDetails.time | 用户感知的「打开慢」 |
| 服务端链路 | 日志中的后端 / 服务端耗时 | 明显小于总耗时 → 剩余可能在传输和前端 |
| SQL 生成 | 服务端耗时远大于引擎 queryTime | MERGE_LIST、多层 GROUPING SETS、复杂编译 |
| 引擎 SQL | cluster history 的 queryTime、scanRows、returnRows | 大扫描、高返回行数、多 JOIN / COUNT DISTINCT |
| 缓存 | 日志或查询结果中的命中状态 | 未命中 = 完整计算;命中仍慢则更像结果集 / 前端 |
| 结果体量 | returnRows、chart query 行数 | 十几万行明细拼在一张卡上 |
若引擎 SQL 本身就是大头,继续走 引擎执行记录分析 和 SQL 性能优化。卡片打开慢而引擎 SQL 只有一两秒时,优先查维度展开、结果行数和 SQL 生成,而不是先改执行计划。
适用场景
- 值班巡检:今天哪些看板卡片打开超过数秒。
- 用户反馈某张卡打开慢:先确认是偶发冷缓存,还是可复现的结果集过大。
- 区分「引擎慢」和「卡片配置把结果打爆」。
- 给看板负责人提供可检查项(维度、时间窗口、结果限制),不越权给出改码方案。